はじめに
Terraform を使ったインフラ管理において、最も過小評価されがちなリスクが「state ファイルの損失」です。アプリケーションの可用性を高めるためにマルチクラウド構成でフェイルオーバーを設計している組織であっても、肝心の Terraform state 自体が単一障害点になっているケースは少なくありません。state が壊れる、または失われると、リソースの実体は動いていても「何がどう管理されているか」という唯一の真実の記録を失うことになり、復旧作業そのものがブロックされてしまいます。
本稿では、Terraform state を「プランB」、つまりマルチクラウドのディザスタリカバリ(DR)戦略の一部として扱うための実践的な方法を、概念・HCL例・運用上の注意点を交えて解説します。
なぜ State のバックアップが DR 戦略の一部になるのか
Terraform の state ファイルには、管理対象リソースの ID、属性、依存関係のグラフが記録されています。たとえ AWS・GCP・Azure 上の実リソースが正常に稼働していても、state を失えば Terraform は「何を知っているべきか」を失い、次のような問題が発生します。
terraform planが全リソースを「新規作成」として検出し、意図しないリソースの重複作成や削除が発生する- モジュール間の依存関係(例: VPC ID を参照する複数モジュール)が解決できなくなる
- import 作業に多大な時間とヒューマンエラーのリスクが発生する
つまり、アプリケーション層のフェイルオーバーだけでなく、「インフラをコードで再構築できる状態」そのものを守ることが、真のディザスタリカバリには不可欠です。state のバックアップと複製は、このための保険です。
基本概念: Remote State とロック
マルチクラウド DR を考える前提として、state は必ずリモートバックエンドで管理し、ロック機構を有効にする必要があります。ローカル state や単一リージョンのバケットだけに依存する構成は、それ自体が障害点になります。
AWS を例にした S3 + DynamoDB バックエンド
terraform {
  backend "s3" {
    bucket         = "okpy-terraform-state-primary"
    key            = "prod/network/terraform.tfstate"
    region         = "ap-northeast-1"
    dynamodb_table = "terraform-state-lock"
    encrypt        = true
  }
}
この構成では S3 がストレージ、DynamoDB がロックを担います。S3 側ではバージョニングを有効化しておくことで、誤った terraform apply による state の破損からも復旧できます。
resource "aws_s3_bucket" "state" {
  bucket = "okpy-terraform-state-primary"
}

resource "aws_s3_bucket_versioning" "state" {
  bucket = aws_s3_bucket.state.id
  versioning_configuration {
    status = "Enabled"
  }
}

resource "aws_s3_bucket_replication_configuration" "state_dr" {
  role   = aws_iam_role.replication.arn
  bucket = aws_s3_bucket.state.id

  rule {
    id     = "state-cross-region-replication"
    status = "Enabled"

    destination {
      bucket        = "arn:aws:s3:::okpy-terraform-state-dr"
      storage_class = "STANDARD_IA"
    }
  }
}
クロスリージョンレプリケーションを設定することで、プライマリリージョンが完全に失われた場合でも、別リージョンの複製バケットから state を取得できます。
マルチクラウドでの state バックアップ戦略
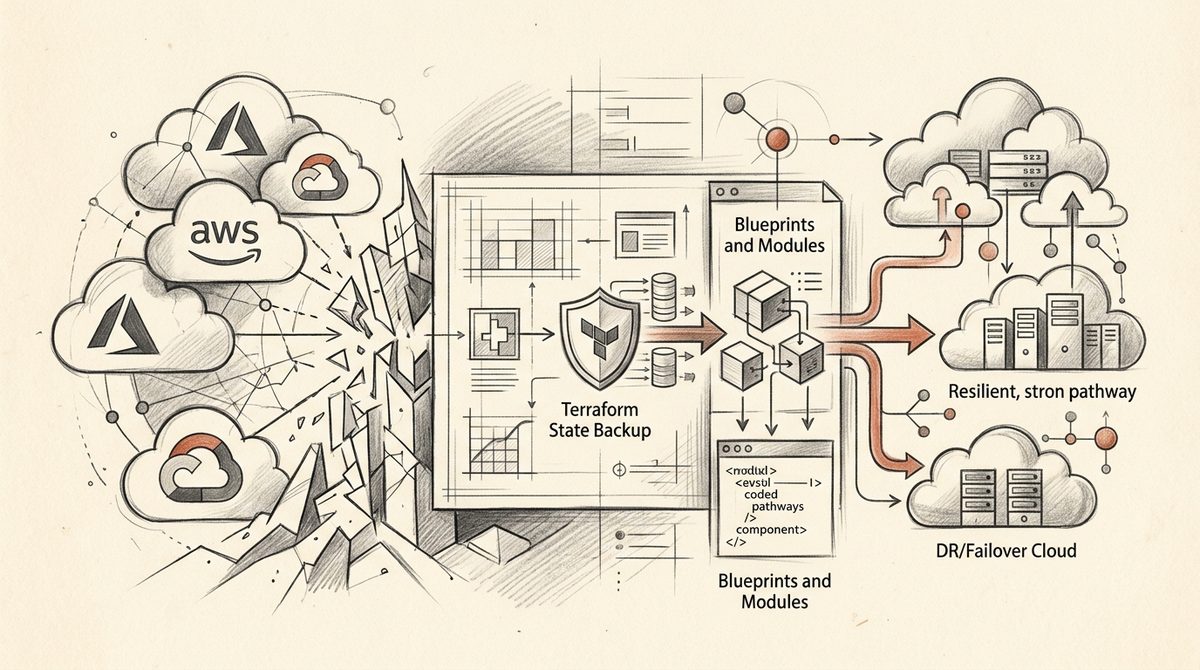
マルチクラウドでフェイルオーバーを構築している場合、state のバックアップ先もクラウドを分散させるのが望ましい設計です。理由は単純で、AWS 全体の障害時に AWS 上にしかバックアップがない state では復旧できないからです。
パターン1: プライマリは AWS、バックアップは GCP
GCS をセカンダリの保管先として、定期的に state をエクスポートする構成です。
# GCP 側(DR用バックアップバケット)
resource "google_storage_bucket" "state_dr" {
  name          = "okpy-terraform-state-dr-gcs"
  location      = "ASIA"
  storage_class = "STANDARD"

  versioning {
    enabled = true
  }

  lifecycle_rule {
    condition {
      age = 90
    }
    action {
      type = "Delete"
    }
  }
}
この GCS バケットへの同期は CI/CD パイプライン内で terraform state pull の結果をアップロードする形で実現します。
# CI の一例(擬似コード)
steps:

  - run: terraform state pull > terraform.tfstate.backup
  - run: gsutil cp terraform.tfstate.backup gs://okpy-terraform-state-dr-gcs/$(date +%Y%m%d%H%M)/terraform.tfstate
パターン2: Azure Blob Storage を第三の保管先にする
3クラウド構成を取る組織であれば、Azure Blob Storage にも同様のバックアップを配置し、単一クラウドベンダーへの依存をさらに減らせます。
resource "azurerm_storage_account" "state_dr" {
  name                     = "okpystatedrbackup"
  resource_group_name      = azurerm_resource_group.dr.name
  location                 = "japaneast"
  account_tier             = "Standard"
  account_replication_type = "GRS" # Geo冗長ストレージ
}

resource "azurerm_storage_container" "state_dr" {
  name                  = "terraform-state-backup"
  storage_account_name  = azurerm_storage_account.state_dr.name
  container_access_type = "private"
}
Azure の GRS(Geo冗長ストレージ)を選択することで、Azure 内でも地理的に離れたペアリージョンへ自動複製される点が利点です。
モジュール設計: state 分割とバックアップの粒度
state を適切に分割しておくことは、バックアップ戦略の実効性を左右します。巨大な単一 state にすべてのリソースを詰め込むと、障害時の復旧スコープが肥大化し、復旧時間(RTO)が伸びます。
modules/
├── network/        # VPC, サブネット, ルーティング
├── compute/        # EC2, GKE, AKS などのコンピュートリソース
├── database/       # RDS, Cloud SQL, Azure Database
└── dr-failover/     # フェイルオーバー関連のDNS, トラフィック制御
各モジュールは独立した backend 設定(state ファイル)を持たせ、クリティカル度の高いモジュール(例: network や dr-failover)ほどバックアップ頻度を上げるという優先順位付けが現実的です。
module "network" {
  source = "./modules/network"
  # backend は per-module に分離
}

module "dr_failover" {
  source     = "./modules/dr-failover"
  depends_on = [module.network]
}
dr-failover モジュールでは、Route 53(AWS)、Cloud DNS(GCP)、Azure Traffic Manager のようなフェイルオーバー用リソースを扱うことが多く、ここの state が壊れるとフェイルオーバーの切替自体ができなくなるため、特に優先してバックアップ対象に含めるべきです。
resource "aws_route53_health_check" "primary" {
  fqdn              = "app.okpy.example.com"
  port              = 443
  type              = "HTTPS"
  resource_path     = "/healthz"
  failure_threshold = 3
  request_interval  = 10
}

resource "aws_route53_record" "failover_primary" {
  zone_id = var.zone_id
  name    = "app.okpy.example.com"
  type    = "A"

  failover_routing_policy {
    type = "PRIMARY"
  }

  set_identifier  = "primary-aws"
  health_check_id = aws_route53_health_check.primary.id
  alias {
    name                   = aws_lb.primary.dns_name
    zone_id                = aws_lb.primary.zone_id
    evaluate_target_health = true
  }
}
復旧手順の概念: state の再構築フロー
実際に state を失った、あるいは破損した場合の復旧フローは次のようになります。
- 最新のバックアップ(S3 バージョニング、GCS/Azure への定期エクスポートなど)を特定する
- バックアップ state をローカルに取得し、整合性を検証する(
terraform showで内容確認) terraform init -reconfigureでバックエンド設定を再適用terraform state pushでバックアップ state を正式な remote state として復元terraform planを実行し、差分がゼロであることを確認(差分がある場合は実リソースとの不整合を個別に調査)
# 復旧手順の例
terraform init -reconfigure
terraform state push terraform.tfstate.backup
terraform plan -out=verify.plan
state の一部リソースだけが失われた軽微なケースでは、terraform import で個別に取り込む方法も有効です。
terraform import aws_instance.app i-0123456789abcdef0
注意点
- バックアップの暗号化は必須: state ファイルには機密情報(DB パスワードや証明書の一部など)が平文で含まれることがあります。S3/GCS/Blob のいずれでもサーバーサイド暗号化を有効にしてください。
- ロックの整合性: 複数クラウドに state をコピーする運用では、どの state が「正」であるかを明確にするルールが必要です。バックアップ先を直接
terraform applyの対象にしてはいけません。 - バックアップの検証を定期的に行う: 取得しているだけで一度も復元テストをしていないバックアップは、機能しない可能性があります。最低でも四半期に一度は復元リハーサルを実施すべきです。
- IAM/権限管理の分離: DR用バックアップバケットへの書き込み権限は、本番の Terraform 実行ロールとは別のロールに制限し、誤削除や不正アクセスのリスクを下げます。
- state のサイズに注意: モジュール分割を怠ると state が肥大化し、バックアップ/復元の時間(=RTO)に直接影響します。
AWS・GCP・Azure との関係
マルチクラウド DR において、各クラウドの役割は次のように整理できます。
- AWS: S3 + DynamoDB によるネイティブな remote backend と state ロックが成熟しており、プライマリの state 保管先として採用されることが多い。
- GCP: GCS バケットのリージョン冗長・マルチリージョン設定がシンプルで、セカンダリのバックアップ先として扱いやすい。
- Azure: Blob Storage の GRS(Geo冗長ストレージ)は地理的な複製をクラウド側で自動化できるため、第三の保管先、あるいは Azure がプライマリの場合の主要バックエンドとして有効。
いずれのクラウドを使うにしても、「state の保管場所」と「実リソースの稼働場所」を意図的に分離しておくことが、単一クラウド障害からの復旧力を高めるポイントです。
FAQ
Q1. state ファイルのバックアップは自動化すべきですか?手動で十分ですか? A. 自動化を強く推奨します。S3 のバージョニングやクロスリージョンレプリケーション、GCS/Azure への定期エクスポートは CI/CD パイプラインに組み込むことで、人為的な取得漏れを防げます。手動バックアップは「最後の手段」としては有効ですが、恒常的な運用には向きません。
Q2. state を複数クラウドに分散バックアップする場合、どちらを「正」とすべきですか?
A. 常にプライマリの remote backend(例: AWS の S3)を正とし、他クラウドへのコピーは read-only のバックアップとして扱うべきです。バックアップ先に直接 terraform apply を実行する運用は避け、復旧時のみ terraform state push で正規の backend に戻す手順を踏んでください。
Q3. state を失った場合、必ず terraform import で復旧する必要がありますか?
A. いいえ。まず直近のバックアップ(S3 バージョニングの過去バージョンや定期エクスポート)から復元できるかを確認するのが先です。バックアップが存在しない、または古すぎて実態と大きくズレている場合に限り、terraform import による個別リソースの取り込みを検討してください。バックアップ戦略が機能していれば、import に頼る場面は最小限に抑えられます。
まとめ
Terraform state のバックアップは、マルチクラウド DR 戦略における「見えないプランB」です。アプリケーションのフェイルオーバー設計に力を入れる一方で、state の冗長化を後回しにすると、いざ復旧が必要な場面でインフラそのものを再構築できなくなるリスクを抱えることになります。リモートバックエンドのバージョニング、クロスクラウドへの定期バックアップ、モジュール単位での state 分割、そして定期的な復元リハーサル。これらを組み合わせることで、state を本当の意味で「失われないもの」にしていくことができます。