はじめに
マイクロサービス構成で Terraform を運用していると、ネットワーク基盤・共有データベース・各サービスのインフラといった複数のレイヤーを個別の Workspace に分割するケースが増えてきます。しかし Workspace を分割すると、「VPC が更新されたらサービス側の Workspace も再適用したい」「共有 RDS の設定変更をフックして API サーバーの Workspace を自動実行したい」といった依存関係の管理が課題になります。
Terraform Cloud(TFC)の Run Triggers は、この Workspace 間の依存関係を宣言的に表現し、上流 Workspace の apply 成功をトリガーにして下流 Workspace の run を自動起動する仕組みです。本記事では概念整理から HCL 実装、state の扱い、モジュール設計、注意点、FAQ までを一通り解説します。
1. Run Triggers の基本概念
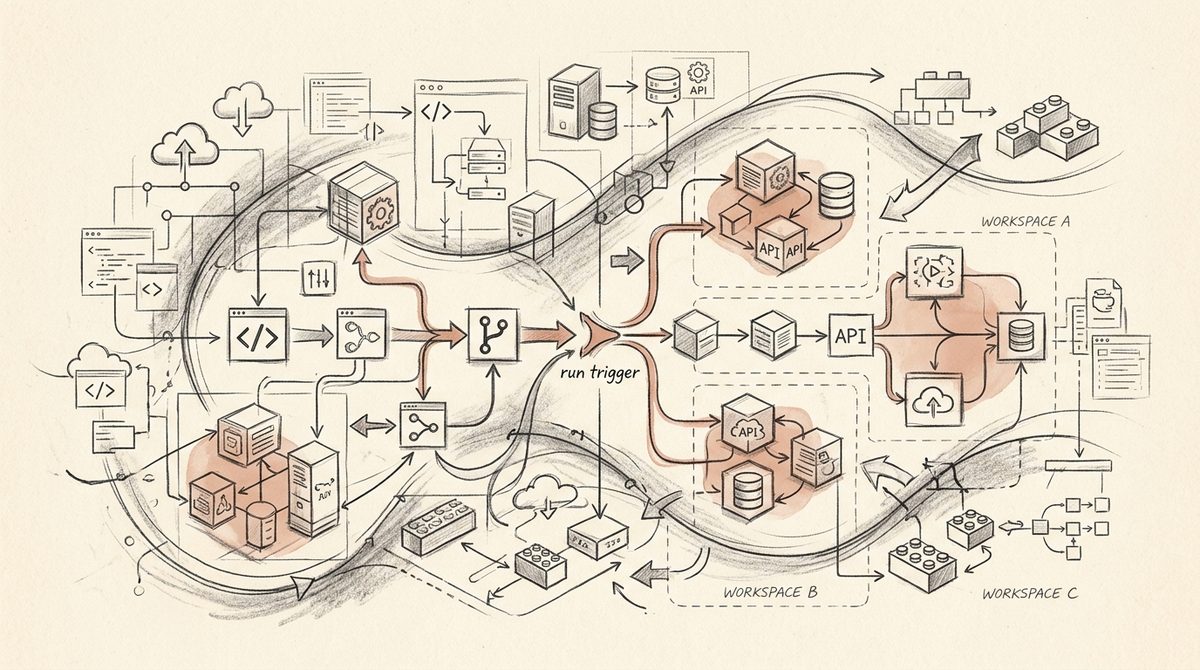
Run Triggers は TFC/TFE の Workspace 設定の一つで、「どの Workspace の apply 完了を監視し、自分自身の run を自動でキューに入れるか」を定義します。
- Source Workspace(上流): 変更の起点となる Workspace。例:
network-foundation - Trigger Workspace(下流): 上流の apply 成功を受けて自動的に run される Workspace。例:
service-api
この関係は「下流側から見て、どの上流を監視するか」という向きで設定します。つまり service-api の Workspace 設定に「network-foundation の run をトリガーとして登録する」という形になります。
重要な特徴:
- デフォルトでは apply が成功した場合のみ 下流がトリガーされます(plan のみの run や失敗した run はトリガーしない)
- 下流の run は自動的に
plan→ 承認待ち、またはauto-apply設定次第でapplyまで進みます - 一つの Workspace は複数の上流 Workspace を Run Trigger として登録できます(fan-in)
- 逆に一つの上流を複数の下流が監視することもできます(fan-out)
マイクロサービス文脈での典型的な依存ツリーはこうなります。
network-foundation (VPC, Subnet, SG)
   └── shared-data-layer (RDS, ElastiCache, SQS)
         ├── service-api
         ├── service-worker
         └── service-gateway
shared-data-layer が更新されると、3つのサービス Workspace が自動的に run をキューイングされる、という構成です。
2. Workspace 構成と HCL 例
2.1 Workspace の分割方針
まず上流側(network-foundation)の最小構成です。
# network-foundation/main.tf
resource "aws_vpc" "main" {
  cidr_block           = "10.0.0.0/16"
  enable_dns_support   = true
  enable_dns_hostnames = true

  tags = {
    Name        = "shared-network"
    Environment = var.environment
  }
}

resource "aws_subnet" "private" {
  for_each          = toset(var.private_subnet_cidrs)
  vpc_id            = aws_vpc.main.id
  cidr_block        = each.value
  availability_zone = var.az_map[each.value]

  tags = {
    Name = "private-${each.value}"
  }
}

output "vpc_id" {
  value = aws_vpc.main.id
}

output "private_subnet_ids" {
  value = [for s in aws_subnet.private : s.id]
}
下流側(service-api)では、上流の output を terraform_remote_state データソースで参照します。
# service-api/data.tf
data "terraform_remote_state" "network" {
  backend = "remote"

  config = {
    organization = "okpy-org"
    workspaces = {
      name = "network-foundation"
    }
  }
}

data "terraform_remote_state" "shared_data" {
  backend = "remote"

  config = {
    organization = "okpy-org"
    workspaces = {
      name = "shared-data-layer"
    }
  }
}
# service-api/main.tf
resource "aws_ecs_service" "api" {
  name            = "api-service"
  cluster         = var.ecs_cluster_arn
  task_definition = aws_ecs_task_definition.api.arn
  desired_count   = var.desired_count

  network_configuration {
    subnets         = data.terraform_remote_state.network.outputs.private_subnet_ids
    security_groups = [aws_security_group.api.id]
  }
}

resource "aws_ecs_task_definition" "api" {
  family                  = "api-service"
  requires_compatibilities = ["FARGATE"]
  cpu                      = 512
  memory                   = 1024

  container_definitions = jsonencode([
    {
      name  = "api"
      image = var.image
      environment = [
        {
          name  = "DB_HOST"
          value = data.terraform_remote_state.shared_data.outputs.rds_endpoint
        }
      ]
    }
  ])
}
2.2 Run Trigger の設定
Run Trigger 自体は Workspace の設定項目であり、HCL の resource ブロックでは表現できません。UI から設定するか、TFC provider(tfe provider)を使って IaC 化するのが一般的です。TFC provider を使うと「Workspace の依存関係自体」もコードで管理できます。
# platform/run_triggers.tf
terraform {
  required_providers {
    tfe = {
      source  = "hashicorp/tfe"
      version = "~> 0.55"
    }
  }
}

data "tfe_workspace" "network_foundation" {
  name         = "network-foundation"
  organization = "okpy-org"
}

data "tfe_workspace" "shared_data_layer" {
  name         = "shared-data-layer"
  organization = "okpy-org"
}

data "tfe_workspace" "service_api" {
  name         = "service-api"
  organization = "okpy-org"
}

# shared-data-layer は network-foundation の apply をトリガーとする
resource "tfe_run_trigger" "data_from_network" {
  workspace_external_id  = data.tfe_workspace.shared_data_layer.id
  sourceable_id          = data.tfe_workspace.network_foundation.id
}

# service-api は shared-data-layer の apply をトリガーとする
resource "tfe_run_trigger" "api_from_data" {
  workspace_external_id  = data.tfe_workspace.service_api.id
  sourceable_id          = data.tfe_workspace.shared_data_layer.id
}
このように「依存関係の管理用 Workspace(platform リポジトリ)」を一つ用意し、tfe_run_trigger リソースで全体のトリガー構成を一元管理すると、依存グラフが PR でレビュー可能になります。
3. State の扱い
Run Triggers 自体は state を共有しません。あくまで「run の起動契機」を連鎖させるだけなので、下流 Workspace が上流の出力値を取得するには、別途下記のいずれかの方法を併用する必要があります。
terraform_remote_stateデータソース(上記の例): 上流 Workspace の state から直接 output を読む。シンプルだが、上流の state 構造が変わると下流が広く壊れるリスクがある- TFC の Workspace 変数 +
tfe_outputsデータソース: TFC provider 経由で特定 Workspace の output のみを型安全に取得する方法。将来的にはこちらが推奨される - 外部ストア経由(SSM Parameter Store, Secrets Manager など): 上流 apply 時に output を SSM に書き込み、下流はそこから読む。state への直接依存を切れるため、クラウド跨ぎや疎結合を重視するマイクロサービス構成では有効
# tfe_outputs を使う例(Terraform 1.5+ / tfe provider 0.48+)
data "tfe_outputs" "shared_data" {
  organization = "okpy-org"
  workspace    = "shared-data-layer"
}

resource "aws_ecs_task_definition" "api" {
  # ...
  container_definitions = jsonencode([
    {
      name  = "api"
      image = var.image
      environment = [
        { name = "DB_HOST", value = data.tfe_outputs.shared_data.values.rds_endpoint }
      ]
    }
  ])
}
state をまたいだ参照は Terraform 的には「暗黙の依存」であり、Run Trigger は「run の自動起動」というオーケストレーション側の依存です。両者は別物であり、Run Trigger を設定しても自動的に remote state 参照ができるわけではない点に注意してください。両方を組み合わせて初めて「上流が変わったら下流も自動で再計算される」という挙動が実現します。
4. モジュール設計のポイント
- モジュール自体に Workspace や Run Trigger の概念を持ち込まない: モジュールはあくまりリソース定義の再利用単位であり、Workspace 分割・トリガー設定はルートモジュール(Workspace の実体)側の責務にする
- Output の契約を明示する: 下流から参照される output は、モジュールの interface として扱い、
variables.tfと同様に意図的に設計する。output 名の変更は破壊的変更とみなし、バージョニングやチェンジログで周知する - 共通モジュールのバージョンピン: 複数の Workspace が同じモジュールを参照する場合、
source = "git::...?ref=v1.2.0"のようにタグ固定し、Run Trigger の連鎖中に意図しないモジュール更新が混入しないようにする - 環境ごとの Workspace 命名規則を統一:
network-foundation-stg/network-foundation-prodのように環境サフィックスを付け、Run Trigger の対応関係を環境単位で完全に分離する。環境を跨いだ誤トリガーは重大インシデントに直結する
5. 注意点・落とし穴
- トリガーの連鎖が多段になるとデバッグが難しい:
network-foundation→shared-data-layer→service-api→service-workerのように3段以上連鎖すると、どこで run が止まったか追うのに時間がかかる。TFC の run 履歴を Workspace ごとに確認する運用フローをあらかじめ決めておく - 自動 apply の暴走リスク: 下流 Workspace を
auto-apply: trueにしていると、上流の意図しない apply が連鎖的に下流まで自動適用されてしまう。本番環境の Workspace は Run Trigger 経由であっても plan まで自動・apply は人間承認 にするのが安全 - 循環依存:
service-api→shared-data-layerのように逆方向の参照を誤って設定すると、理論上は無限ループにはなりませんが(TFC は同一 run に対する再トリガーを防止する)、依存グラフが崩れて意図しない順序で run が走る原因になる。tfe_run_triggerをコードで管理し、グラフを可視化・レビューすることで防止する - Run Trigger は VCS からの直接 push とは独立: Workspace が VCS 連携されている場合、PR マージによる run と Run Trigger による run の両方が走る可能性がある。意図しない二重 run を避けるため、下流側は「API-driven」または「CLI-driven」Workspace にし、VCS 連携は上流のみにするといった運用が有効
- Sentinel / OPA ポリシーとの相互作用: Run Trigger で起動した run にも Policy Check は適用される。下流で policy が fail すると run は停止するため、上流の apply 自体は成功していても下流が反映されない状態が発生しうる。アラート設計にこのケースを含める
- TFC の API レートリミットとキュー: fan-out 構成(1つの上流に対し多数の下流)では、上流 apply のたびに大量の run が一斉にキューイングされる。Workspace の同時実行数設定や Agent プールのキャパシティを事前に確認しておく
6. AWS / GCP / Azure との関係
Run Triggers 自体はクラウドプロバイダー中立な TFC の機能であり、特定のクラウドに依存しません。マイクロサービス構成でよく見る対応は以下の通りです。
- AWS: VPC/Subnet(
network-foundation)→ RDS/ElastiCache(shared-data-layer)→ ECS/EKS 上の各サービス、という3層構成が典型。IAM ロールやセキュリティグループの ID を remote state 経由で下流に渡すケースが多い - GCP: VPC(
network-foundation)→ Cloud SQL / Memorystore(shared-data-layer)→ Cloud Run / GKE サービス、という構成。GCP では Shared VPC のホストプロジェクトを上流 Workspace として分離し、サービスプロジェクト側を下流にする設計がよく使われる - Azure: VNet(
network-foundation)→ Azure SQL / Redis Cache(shared-data-layer)→ AKS / App Service、という構成。Azure では Resource Group 単位で Workspace を分けつつ、Management Group レベルのポリシーと Sentinel を併用するケースが多い
マルチクラウド構成であっても、Run Trigger はあくまり「TFC Workspace 間の run オーケストレーション」なので、上流が AWS、下流が GCP といった跨クラウドの依存関係もそのまま表現できます。クラウドをまたぐ output の受け渡しには、state 直接参照よりも SSM / Secret Manager / Parameter Store のような外部ストアを使う方が疎結合になりやすいです。
7. FAQ
Q1. Run Trigger と depends_on はどう違いますか?
depends_on は同一 Terraform 設定内(同じ state)でのリソース間の適用順序を制御するものです。Run Trigger はそれとは全く別の層で動作し、異なる Workspace(異なる state)間の run 実行順序を制御します。同一 Workspace 内のリソース依存は depends_on や暗黙の参照で解決し、Workspace を跨ぐ実行順序の自動化には Run Trigger を使う、という切り分けになります。
Q2. 下流の Workspace で上流の変更内容だけを選んで apply をスキップしたい場合はどうすればいいですか?
Run Trigger 自体には「どの変更ならトリガーするか」を細かく制御する条件分岐の機能はありません。トリガーされた run は必ず下流の plan が実行されます。この plan の結果、実質的な差分がなければ apply しても何も変わらないため実害は小さいですが、「特定の変更のときだけ下流を動かしたい」という要件がある場合は、Run Trigger ではなく CI/CD パイプライン(例: GitHub Actions から TFC API を呼び出し、条件分岐を入れてから run を起動する)で代替する方が柔軟です。
Q3. Terraform OSS(無償版)でも Run Triggers は使えますか?
いいえ、Run Triggers は Terraform Cloud / Terraform Enterprise の機能であり、OSS 版の Terraform CLI 単体では利用できません。OSS 版で同様の挙動を実現したい場合は、CI/CD パイプライン側で Workspace A の apply 完了を検知して Workspace B の terraform apply をキックするジョブを組む、または Atlantis のようなツールでカスタムワークフローを構築する必要があります。
おわりに
Run Triggers は、マイクロサービス構成で Workspace を適切に分割しつつ、依存関係の再適用を手動運用に頼らず自動化するための有効な手段です。ただし、依存グラフが大きくなるほど「どこまで自動化し、どこで人間の承認を挟むか」の設計判断が重要になります。tfe_run_trigger リソースで依存関係自体をコード管理し、PR レビューの対象にすることで、Workspace 間の結合度を可視化しながら安全に運用していくことをお勧めします。